
答案是:OpenAI 已表示,ChatGPT 可供逾 10 億名每週活躍使用者使用。這項說法來自 OpenAI 於 2026 年 8 月 31 日發布的官方文章。
不過,OpenAI 隨後在 9 月 11 日公開的 Habitat 工程文章裡,還揭露了另一組容易被混淆的規模數字:Habitat 支援的產品每週服務逾 10 億人、每秒處理逾 7,000 萬次請求,並服務逾 500PB 資料。這裡的「逾 10 億人」是 Habitat 所支援產品的口徑,不應直接當成單一 ChatGPT 產品的統計。
兩者合起來看,能更清楚理解一件事:ChatGPT 的使用規模是一項產品層級的指標;而 Habitat 則是支撐 ChatGPT、API、Codex 與內部服務存取資料的底層線上儲存平台。
OpenAI 到底公布了什麼?先分清兩個「10 億」口徑
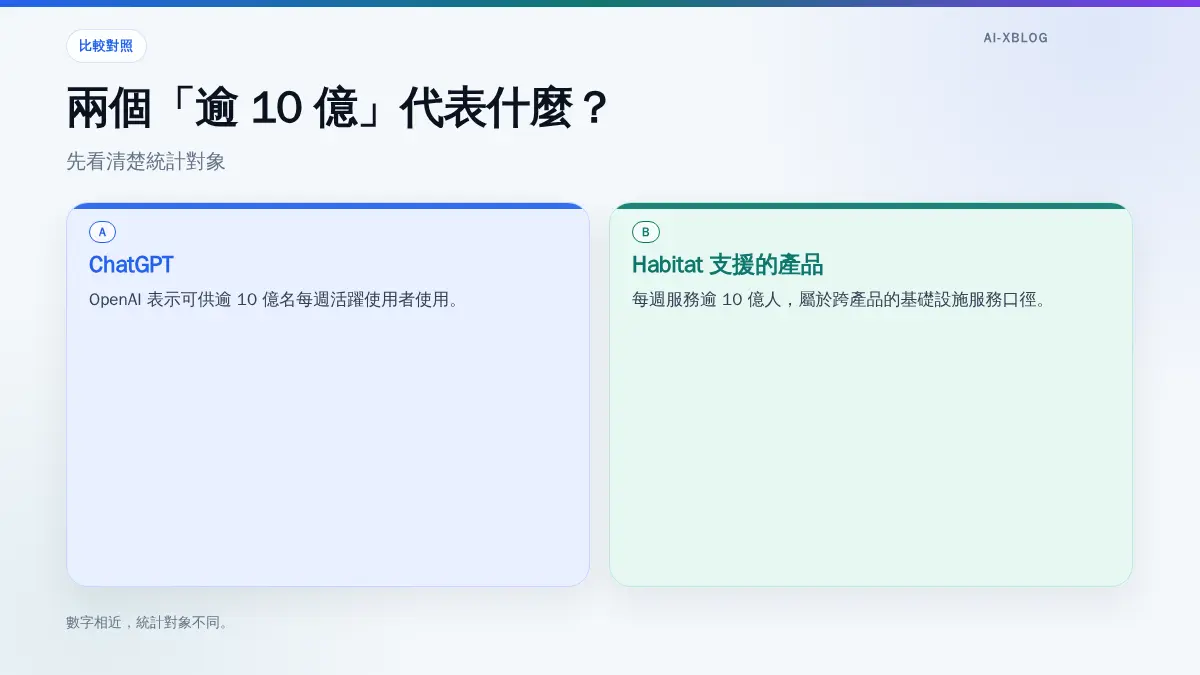
這次消息最關鍵的地方,不只是數字很大,而是每個數字所描述的對象不同。
| 官方說法 | 統計對象 | 應如何理解 |
|---|---|---|
| ChatGPT 可供逾 10 億名每週活躍使用者使用 | ChatGPT | 這是 OpenAI 對 ChatGPT 使用規模的直接表述。 |
| Habitat 支援的產品每週服務逾 10 億人 | Habitat 支援的產品 | 這是跨產品的基礎設施服務口徑,不能與 ChatGPT 單一產品的使用者數混用。 |
因此,搜尋「ChatGPT 10 億用戶」時,可以確認 OpenAI 確實已對 ChatGPT 做出逾 10 億名每週活躍使用者的表述;但在閱讀 Habitat 的工程規模時,也要保留它所描述的是多項產品共用的資料服務層。
Habitat 是什麼?不是模型,而是 OpenAI 的線上儲存平台
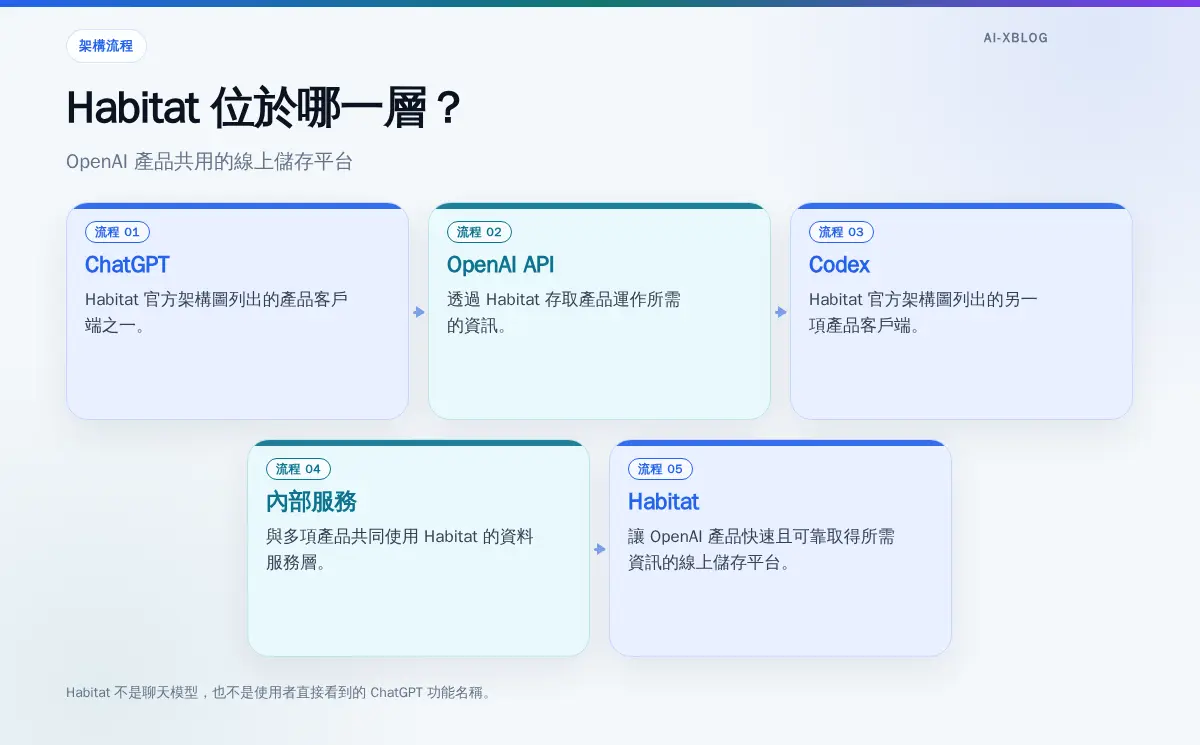
依據 OpenAI 的官方工程文章,Habitat 是讓 OpenAI 產品能快速且可靠取得所需資訊的線上儲存平台。
換句話說,Habitat 並不是與使用者對話的模型,也不是使用者在 ChatGPT 介面中會直接看到的功能名稱。它處理的是產品在運作過程中需要讀取與取得資訊的資料存取工作。
官方架構圖列出的 Habitat 客戶端包括:
- ChatGPT
- OpenAI API
- Codex
- 內部服務
這個列表說明,Habitat 的規模不能只用 ChatGPT 一項服務來解釋。它位於多個 OpenAI 產品與服務共用的資料層,因此其請求量與資料規模反映的是整體平台運作需求。
為什麼 ChatGPT、Codex 與 API 會需要這麼多資料查找?
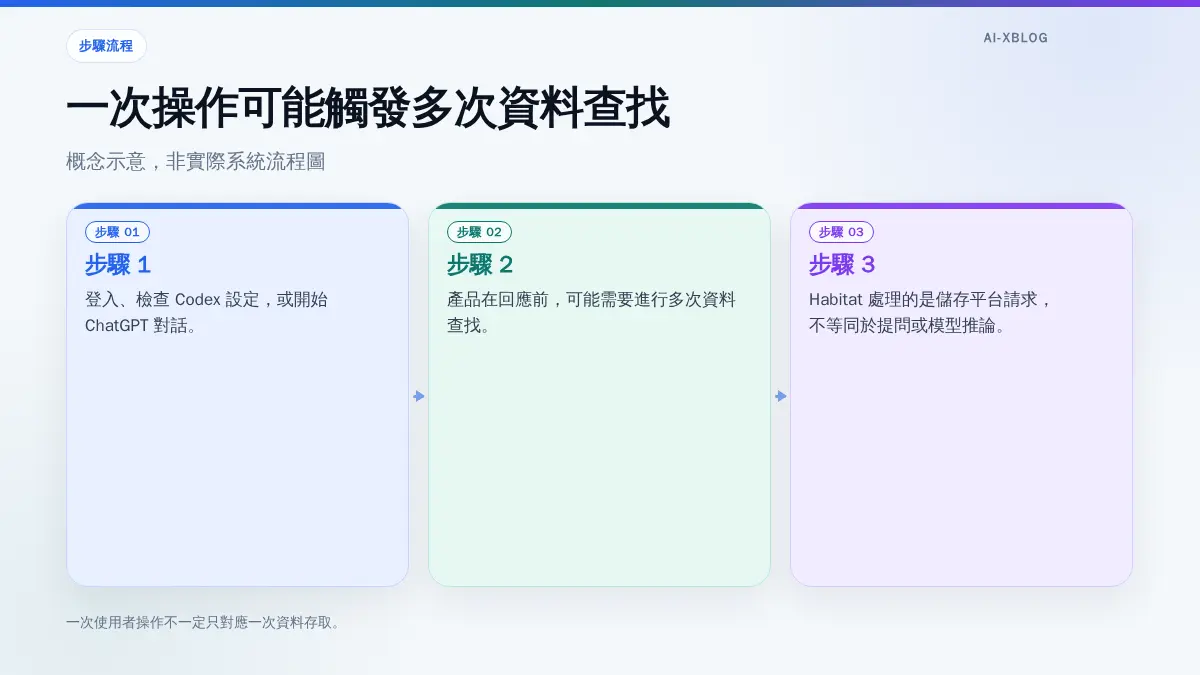
一個使用者看似簡單的操作,在系統內部不一定只對應一次資料存取。
OpenAI 舉例,使用者登入、檢查 Codex 設定,或開始一段 ChatGPT 對話時,系統在回應之前都可能需要進行多次資料查找。這是理解 Habitat 每秒請求量的核心背景。
因此,Habitat 的「每秒逾 7,000 萬次請求」是儲存平台請求的數字。它不能直接換算成:
- 每秒有 7,000 萬人向 ChatGPT 提問;
- 每秒有 7,000 萬次模型推論;
- 每秒有 7,000 萬則使用者訊息;
- 每秒有 7,000 萬名使用者同時在線。
原因很直接:單一登入、設定檢查或對話開始動作,就可能觸發多次資料查找;而 Habitat 也同時支援不只一項產品。
7,000 萬 requests/s 與 500PB 資料,代表什麼?
OpenAI 表示,Habitat 每秒處理逾 7,000 萬次請求,並服務逾 500PB 資料。這兩項指標分別描述不同面向:
- 每秒逾 7,000 萬次請求:描述 Habitat 作為線上儲存平台所處理的資料存取請求量。
- 逾 500PB 資料:描述 Habitat 服務的資料規模。
值得留意的是,500PB 不應被直接解讀成「全部都是 ChatGPT 對話紀錄」,也不宜自行將其換算成特定類型的實體儲存容量。官方在此公布的是 Habitat 所服務的資料規模,而不是對特定資料類別做細分說明。
對一般讀者而言,這組數字更適合被視為一個訊號:當 AI 產品的使用規模擴大後,挑戰不只在於模型如何產生回答,也在於帳號、設定與產品流程所需的資料,能否在大量請求下持續被快速取得。
Habitat 為何不用任意 SQL 查詢?重點是可預測性
OpenAI 說明,Habitat 採用受限制的 NoSQL API,而不是開放可任意執行的 SQL 查詢。官方特別提到,任意 SQL 查詢可能導致大型掃描或跨表 joins。
這項設計取捨的重點,在於讓資料存取模式更容易受到控制。在每秒要處理大量儲存請求的環境中,若個別查詢可能觸發難以預期的大範圍掃描,整體系統的資源使用與回應表現就更難掌握。
因此,Habitat 的設計可從兩個角度理解:
- 限制查詢自由度:避免任意查詢帶來大型掃描或跨表 joins 的風險。
- 維持線上服務需求:讓產品在需要頻繁資料查找時,能以較受控的方式取得資訊。
這不代表 NoSQL 在所有情境都優於 SQL,而是 OpenAI 在 Habitat 這個大規模線上儲存場景中,選擇了限制查詢能力的架構方向。
這對 ChatGPT 使用者與 API 開發者有何意義?
對多數 ChatGPT 使用者來說,Habitat 是看不見的底層系統;但官方揭露讓外界看到,一次登入、設定讀取或開啟對話背後,可能牽涉多次資料查找。
對開發者而言,這也提供一個平台工程層面的觀察:當服務同時面對大量使用者、不同產品入口與高頻資料存取時,模型本身以外的資料層設計同樣重要。帳號狀態、設定與其他產品運作所需資訊,都必須能在高流量下被有效讀取。
至於台灣開發者,OpenAI 的官方 API 支援國家/地區清單目前列出台灣;不過 Habitat 本文談的是 OpenAI 產品背後的儲存架構,並非提供 Habitat 的使用教學或開發介面說明。
重點整理:別把基礎設施數字當成單一產品流量
OpenAI 這次同時提供了產品使用規模與底層儲存架構的兩種視角。最重要的閱讀原則,是把不同數字放回正確的統計口徑:
- ChatGPT 的逾 10 億名每週活躍使用者,是 OpenAI 對 ChatGPT 做出的直接表述。
- Habitat 支援產品每週服務逾 10 億人,則是跨產品的基礎設施服務口徑。
- 每秒逾 7,000 萬次請求,是 Habitat 的儲存平台請求量,不是提問數或模型推論數。
- 逾 500PB 描述 Habitat 服務的資料規模,不能直接等同於特定一種資料內容。
如果未來 OpenAI 持續公開更多基礎設施細節,外界將能更具體觀察:超大規模 AI 服務如何在模型、產品與資料層之間協調運作。
本文數據與定義以 OpenAI 於 2026 年 8 月 31 日及 9 月 11 日公開的資料為準。