
OpenAI 在 2026 年 9 月 22 日發布 GPT-6 Sol 與 GPT-6 Luna。若你正在評估 API 成本與任務分工,最先要看的不是模型名稱,而是兩件事:任務是否屬於複雜 coding/agent 工作流,以及 GPT-6 Sol 的單次輸入是否可能超過 272K tokens。
以 API Standard 的短 context 費率來看,GPT-6 Sol 的未快取輸入為每百萬 tokens US$2,GPT-6 Luna 則為 US$0.10;但 Sol 在輸入超過 272K tokens 時,整筆請求會套用不同倍率。因此,長文件、龐大程式碼庫或累積式 agent context,不能只用短 context 的輸入單價預算。
GPT-6 Sol 與 Luna 發布重點:模型 ID、日期與 API 端點
依 OpenAI API changelog,GPT-6 Sol 與 GPT-6 Luna 於 2026 年 9 月 22 日發布:
- GPT-6 Sol:
gpt-6-sol - GPT-6 Luna:
gpt-6-luna - 可使用的 API:Responses API 與 Chat Completions API
這篇的價格均指 API 的 Standard、short-context 費率,單位為每 1M(100 萬)tokens。它不等於 ChatGPT Work 或 Codex 的訂閱、工作區用量或企業合約條件。
GPT-6 Sol vs. Luna:先按任務型態選模型
GPT-6 Sol 模型頁將 Sol 定位於複雜 coding 與 agentic workflows;GPT-6 Luna 模型頁則將 Luna 定位為聚焦、高量任務的最高效率模型。
| 模型 | 官方定位 | 選型時應優先檢查的條件 |
|---|---|---|
| GPT-6 Sol | 複雜 coding 與 agentic workflows | 任務是否涉及複雜工作流;單次輸入是否可能超過 272K tokens |
| GPT-6 Luna | 聚焦、高量任務的最高效率模型 | 工作是否能拆為聚焦、可大量執行的任務;實際 token 結構是否符合成本目標 |
這代表一個實務上的判斷方式:若你的工作需要處理複雜的 coding 或 agent 流程,可先評估 Sol;若工作可拆成大量、聚焦的處理單位,Luna 是較值得優先評估的方向。這是依官方模型定位做出的選型判斷,不代表任一模型必然適合所有情境。
GPT-6 Sol API 價格與 Luna Standard 短 context 價格
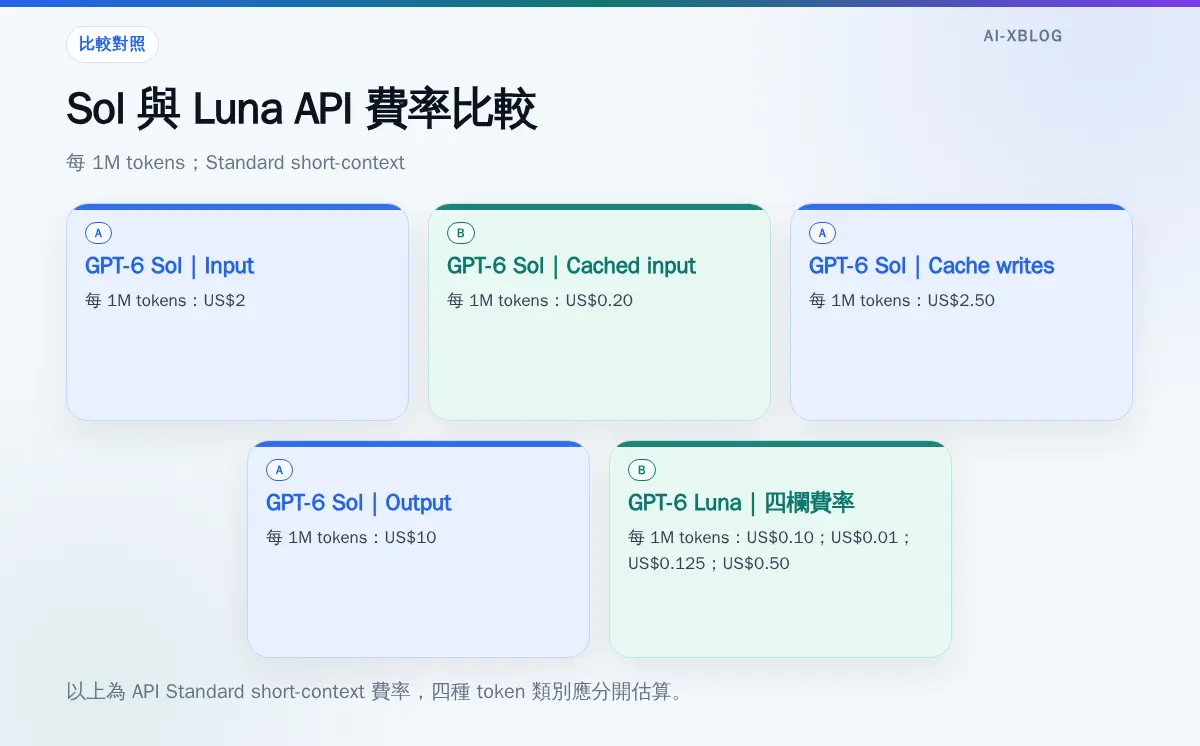
以下整理 OpenAI API 定價頁的 Standard short-context 費率。四個欄位都要分開看:input、cached input、cache writes 與 output 各有不同價格。
| 模型 | Input | Cached input | Cache writes | Output |
|---|---|---|---|---|
| GPT-6 Sol | US$2 | US$0.20 | US$2.50 | US$10 |
| GPT-6 Luna | US$0.10 | US$0.01 | US$0.125 | US$0.50 |
表中全部數字均為每 1M tokens 的 API Standard short-context 費率。完整現行價格條件請以 OpenAI API Pricing 為準。
讀價格表時,別把四個 token 類別混成一筆成本
定價表將 input、cached input、cache writes 與 output 分為不同計費欄位。以 Sol 為例,input 是每 1M tokens US$2,cached input 是 US$0.20,而 cache writes 是 US$2.50;三者不是同一個單價的不同寫法。
因此,若你的應用會出現 cached input 或 cache writes,成本估算應分欄計算,而不是只拿未快取 input 單價乘上全部輸入 tokens。同樣地,若回傳內容很長,output 單價也應獨立納入預算。
超過 272K input tokens:GPT-6 Sol 為何不能只看短 context 單價?
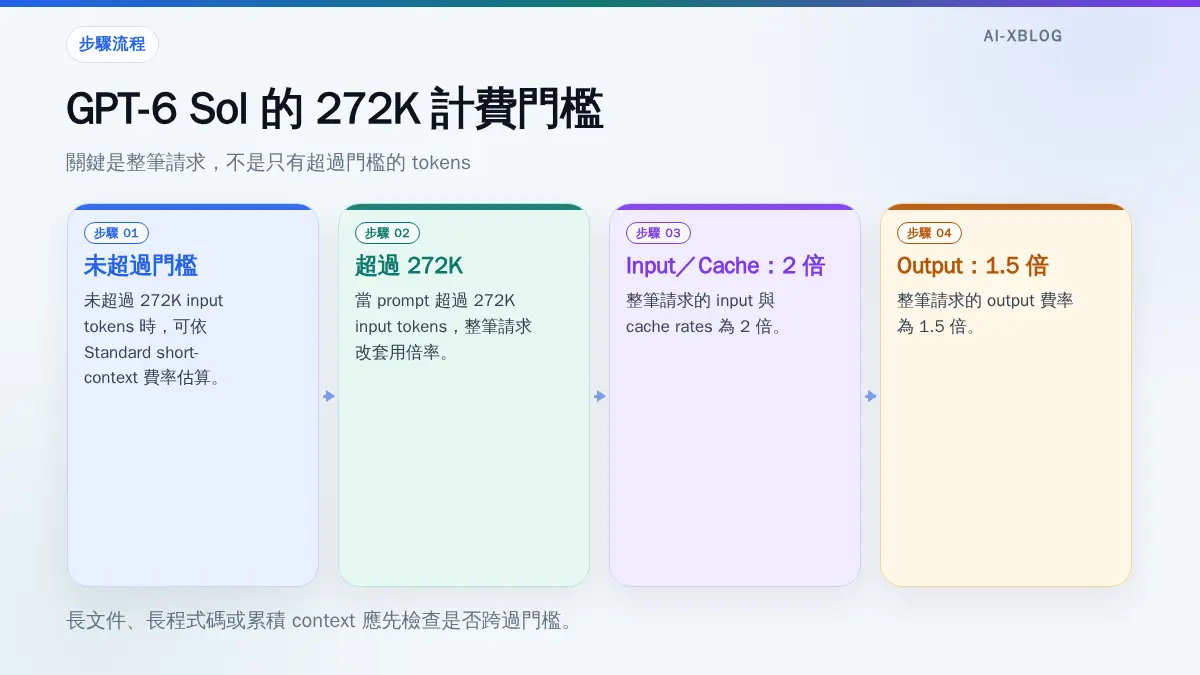
GPT-6 Sol 的規則是:當 prompt 超過 272K input tokens,整筆請求會以 2 倍的 input 與 cache rates、以及 1.5 倍的 output 費率計價。
關鍵在於「整筆請求」。這不是只對超過門檻的那一小段輸入另加價。因此,若你的流程可能一次帶入很長的文件、程式碼或累積 context,應先確認是否會跨過 272K input tokens,再估算成本。
- 未超過門檻時:可依 Standard short-context 表的 Sol 費率估算。
- 超過 272K input tokens 時:Sol 的整筆請求改採 input/cache rates 2 倍、output 1.5 倍的規則。
換句話說,Sol 的選型不能只比較「US$2 input」與 Luna 的「US$0.10 input」。若預期有超長輸入,計費門檻本身就是架構設計與成本預算的一部分。
API、ChatGPT Work、Codex 與一般 ChatGPT 對話:可用性要分開看
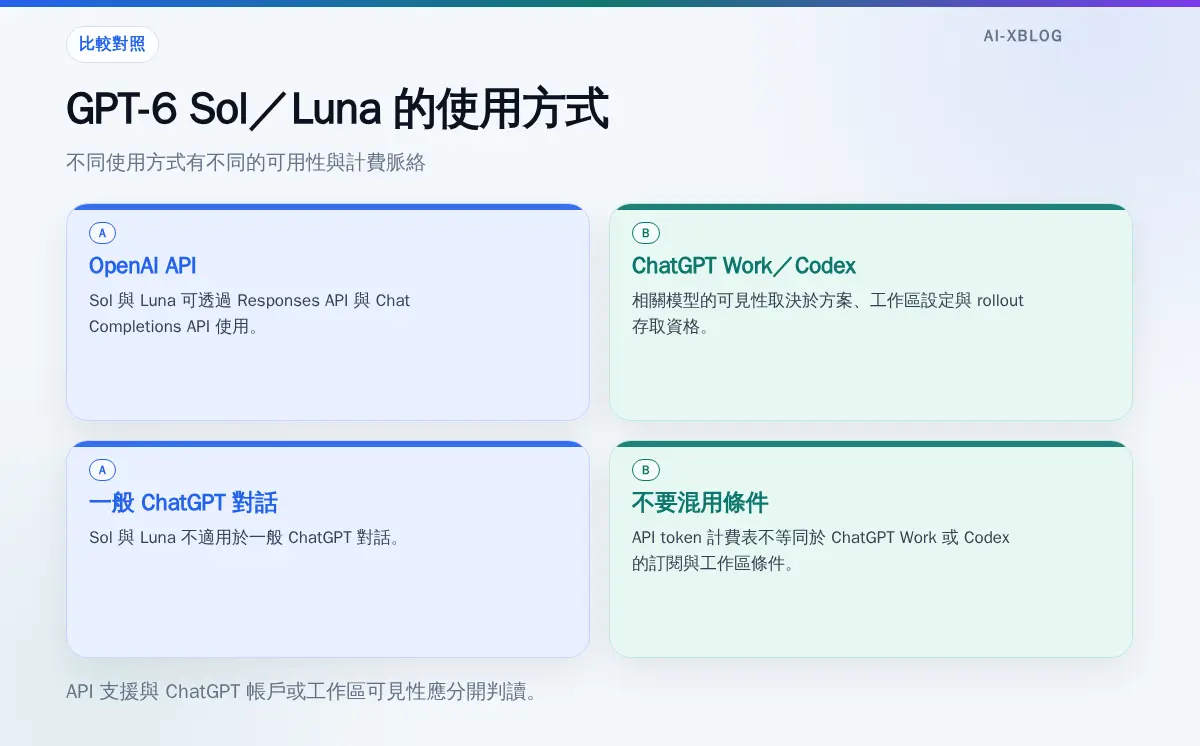
在 API 端,Sol 與 Luna 可透過 Responses API 與 Chat Completions API 使用。至於 ChatGPT 產品面,兩者屬於 ChatGPT Work 與 Codex 的模型,不適用於一般 ChatGPT 對話。
依 OpenAI 的 Work 與 Codex 說明,模型在 Work/Codex 中的可見性取決於方案、工作區設定與 rollout 存取資格。這表示不能把 API 已發布,直接解讀成每一個 ChatGPT 帳戶都能立刻在介面中選到模型。
| 使用方式 | 本次可確認的資訊 |
|---|---|
| OpenAI API | 可透過 Responses API 與 Chat Completions API 使用 Sol 與 Luna。 |
| ChatGPT Work/Codex | Sol 與 Luna 為相關模型;可見性取決於方案、工作區設定與 rollout 存取資格。 |
| 一般 ChatGPT 對話 | Sol 與 Luna 不適用於一般 ChatGPT 對話。 |
此外,ChatGPT Work/Codex 的訂閱或工作區條件,不應與 API 的 token 計費表混為一談。本文整理的金額只適用於 API Standard short-context 的每百萬 tokens 計價。
台灣讀者怎麼看:API 支援台灣,不等於所有 ChatGPT 帳戶皆可見
OpenAI API 支援國家與地區清單目前列有 Taiwan。這可用來確認 API 支援地區資訊,但不能推論每個台灣 ChatGPT 帳戶、方案或工作區都能使用 Work、Codex、Sol 或 Luna。
如果你的團隊是透過 ChatGPT Work 或 Codex 存取模型,應以工作區內實際可見的模型與管理設定為準;若是 API 導入,則應按 API 文件、用量與 token 結構規劃。
實務選型:用「任務複雜度+context 長度+token 結構」做決定
可先用以下順序篩選,而不是只挑表面單價最低的模型:
- 先定義工作型態:複雜 coding 與 agentic workflows,優先評估 Sol;聚焦且高量的任務,優先評估 Luna。
- 再拆 token 成本:把 input、cached input、cache writes 與 output 分開估算。
- 最後檢查 Sol 的 context 門檻:若單次 prompt 可能超過 272K input tokens,需將整筆請求的倍率納入。
例如,假設某個流程需要大量處理彼此獨立、目標明確的請求,Luna 的官方定位與較低的 Standard short-context 各欄費率,會是值得優先檢視的組合。反之,假設流程核心是複雜 coding 或 agent 協作,Sol 的官方定位更貼近該需求,但仍應先確認長 context 是否會觸發 272K 門檻。
避免兩種常見誤讀
1. 不要把 API 價格當成 ChatGPT 訂閱價格
本篇的 US$ 金額是 API Standard short-context 的 token 費率,不是 ChatGPT Work、Codex 或其他 ChatGPT 方案的固定訂閱金額,也不是工作區用量額度。
2. 不要把短 context 價格套用到所有 Sol 請求
Sol 的 prompt 超過 272K input tokens 後,整筆請求會改按指定倍率計價。對長文件、長程式碼或持續累積 context 的流程,這項條件可能比短 context input 單價更影響預算。
結論:Sol 看複雜工作流,Luna 看聚焦高量;成本要看完整 token 結構
GPT-6 Sol 與 GPT-6 Luna 都已於 2026 年 9 月 22 日透過 OpenAI API 發布。Sol 的重點是複雜 coding 與 agentic workflows;Luna 的重點是聚焦、高量任務。
在成本面,兩者的 Standard short-context 價格差異明顯,但真正的選型不應停在未快取 input 單價。請將 cached input、cache writes、output 一併列入,並在考慮 Sol 時額外檢查單次 prompt 是否會超過 272K input tokens。若你是從 ChatGPT Work 或 Codex 使用,也要將工作區可見性與 API 計費分開判讀。