
想用 Antigravity SDK 本機 AI 執行 Agent,現在有兩條官方文件列出的路徑:透過 LiteRTAgentConfig 在裝置上執行 Gemma 4 26B A4B 等 .litertlm 模型,或透過 LocalOpenAIAgentConfig 連接提供 OpenAI-compatible API 的本機伺服器。Google 本機模型指南指出,本機模型 Agent 可不使用 API 金鑰或網路連線執行。這裡談的是 SDK 工作流程,不能直接推定 Antigravity IDE、CLI 或雲端託管 API 也適用相同設定。
Antigravity SDK 本機 AI:9 月 23 日公告了什麼?
Google 於 2026 年 9 月 23 日公告 Antigravity SDK 支援本機模型工作流程。對開發者而言,關鍵選擇不是「要不要使用雲端」這麼簡單,而是模型執行留在本機,或讓雲端模型參與規劃、再由本機模型執行任務。
兩條本機路徑怎麼選?
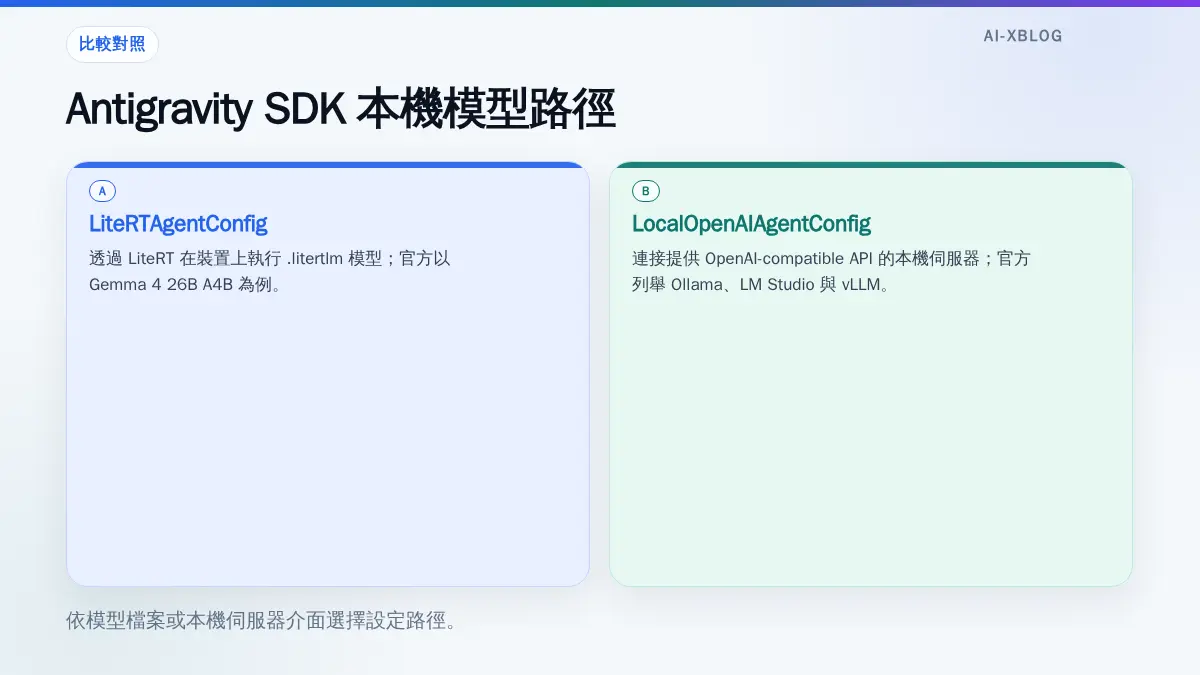
| 路徑 | 官方文件確認的用法 | 評估重點 |
|---|---|---|
| LiteRTAgentConfig | 透過 LiteRT 在裝置上執行 .litertlm 模型;官方以 Gemma 4 26B A4B 為例。 | 先確認要使用的模型檔案與設備資源,再依官方指南設定。 |
| LocalOpenAIAgentConfig | 連接提供 OpenAI-compatible API 的本機伺服器;官方列舉 Ollama、LM Studio 與 vLLM。 | 先確認自己的本機伺服器提供所需介面,再依官方指南設定。 |
如果已準備使用上述類型的本機伺服器,第二條路徑較貼近你的設定方向;如果要依 Google 的 Gemma 4 26B A4B 範例操作,則可從 LiteRT 路徑開始。這是依兩種設定方式所做的選擇建議,不代表兩條路徑具有相同的模型相容性或執行表現。
Gemma 4 26B A4B:24 GB 與 16.8 GB 不要混為一談
依現行指南,Google 建議執行其示範的 Gemma 4 26B A4B checkpoint 時,設備具備至少 24 GB VRAM 或統一記憶體;該 checkpoint 的下載量約 16.8 GB。前者是設備記憶體建議,後者是模型下載量,不是另一個記憶體門檻。24 GB 也不應解讀為達標就保證能順利執行。
準備採用 LiteRT 路徑時,可先對照官方指南的安裝、模型取得與設定步驟,再評估自己的設備是否適合。本文不把單一示範模型的條件延伸為所有 .litertlm 檔案的相容性保證。
雲端規劃、本機執行,資料會流向哪裡?
Google 展示過一種混合流程:雲端 Gemini 3.8 Flash 根據檔名與任務描述制定規劃,本機 Gemma Agent 執行後續工作。因此,這種展示與不使用網路連線的純本機流程不同;評估資料流向時,不能只看執行任務的模型位於哪裡。
Google 報告,在其三個 Python 模組的稽核修補展示中,97.2% 的 token 在本機處理。這是該次展示的結果,不能當成其他工作負載的本機處理比例,更不能換算成固定節費率。若檔名或任務描述也屬於不宜傳送的資訊,純本機路徑比照搬該混合展示更符合「不讓這些資訊進入雲端規劃」的需求。
本機執行能省下什麼?先分清成本邊界
官方指南確認,本機模型 Agent 可以不使用 API 金鑰或網路連線執行。因此,若工作流程維持純本機,就不需要為該模型執行步驟呼叫雲端模型 API。這不等於整體成本為零:採用前仍應把設備資源及運作成本納入評估;若改用 Gemini 3.8 Flash 參與規劃,也不能把混合流程視為沒有雲端用量。
選擇本機路徑時,應依所選模型評估設備資源;若評估 Google 展示的混合流程,則須另外留意檔名與任務描述會進入雲端規劃。若目標是降低雲端模型呼叫或減少資料傳送,應以自己的工作流程逐項檢查,而不是套用單次展示的 token 比例。